想像一個情況,手上同時有兩個 feature 在開發,A 做到一半,B 又要先處理。用同一個資料夾的話,只能先 stash A 的修改、切分支去做 B,做完再切回來 pop。git worktree 讓同一個 repo 有多個工作目錄,A 和 B 各用一個,切換就是換資料夾。
一、git worktree 本來在解什麼
沒有 git worktree 時,想同時在兩個分支上工作,只能在同一個目錄裡下 git stash 再切分支,或是另外 clone 一份 repo。stash 切來切去容易搞亂半成品,額外 clone 一個又佔空間,兩份 repo 之間的 commit 還要 push / pull 才能互通。
git worktree 讓同一份 repo 在本地有多個工作目錄。每個目錄各自 checkout 一個分支,commit 歷史共用。
工作目錄(working tree)指的是 checkout 出來、實際在編輯的那些檔案。原本 clone 下來的資料夾就是一個 worktree,文中叫它主目錄,用 git worktree add 開出來的資料夾則是額外的 worktree,它們都是工作目錄,各自有自己的分支和暫存區,commit 與分支則共用同一個 .git。之後提到的 worktree,指的就是這些資料夾。
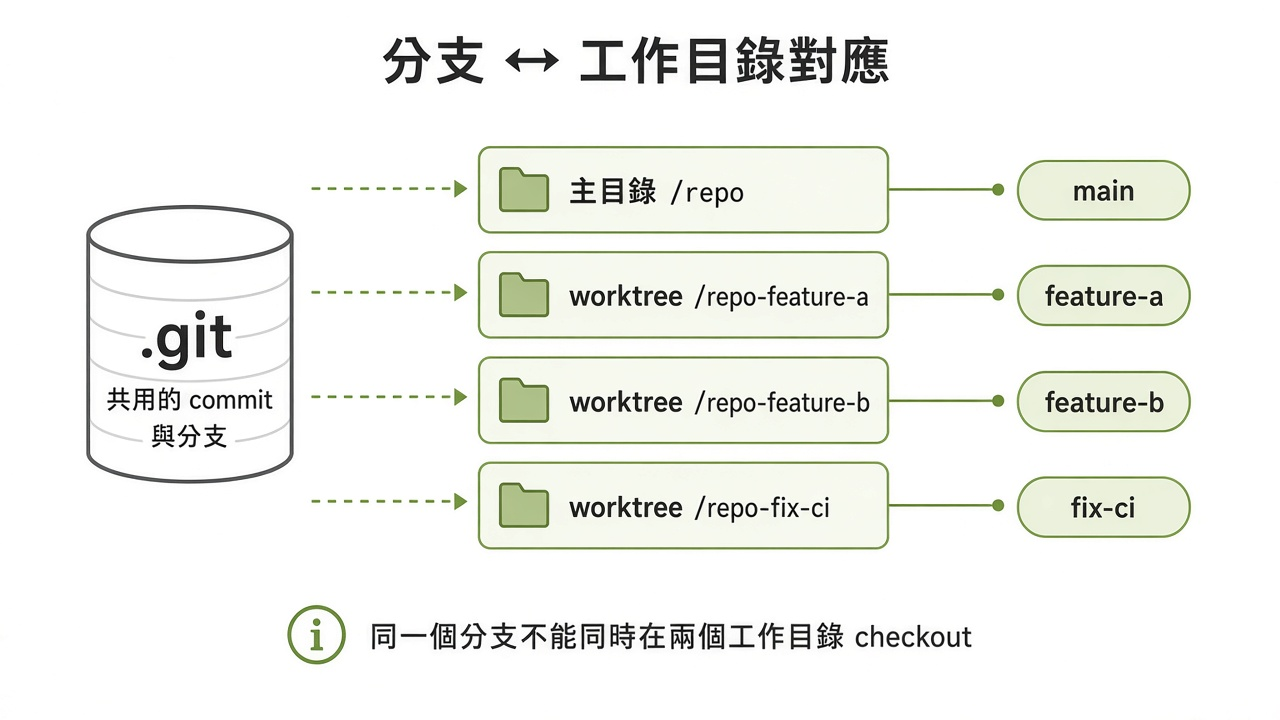
簡介 worktree 的生命週期
1)建立新的工作目錄
透過 git worktree add 將 worktree 建立出來,旁邊多出 demo-feat 資料夾,裡面是完整的專案檔案,已經在新分支 feat 上,不需要重新 clone。一個分支同一時間只能被一個 worktree 使用:
$ git worktree add ../demo-feat -b feat
Preparing worktree (new branch 'feat')

$ ls ..
demo  demo-feat
在另一個資料夾也開 feat,git 會拒絕:
$ git worktree add ../x feat
fatal: 'feat' is already used by worktree at '/tmp/wt/demo-feat'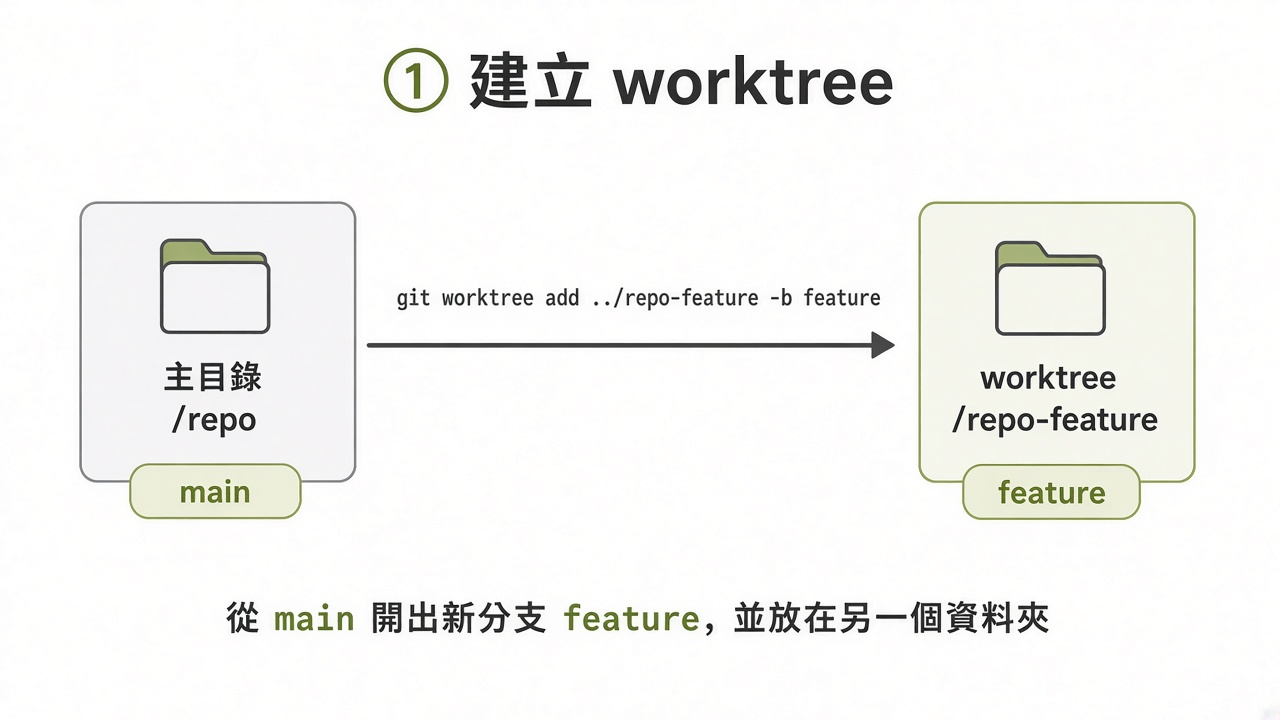
2)在 worktree 裡照常 commit
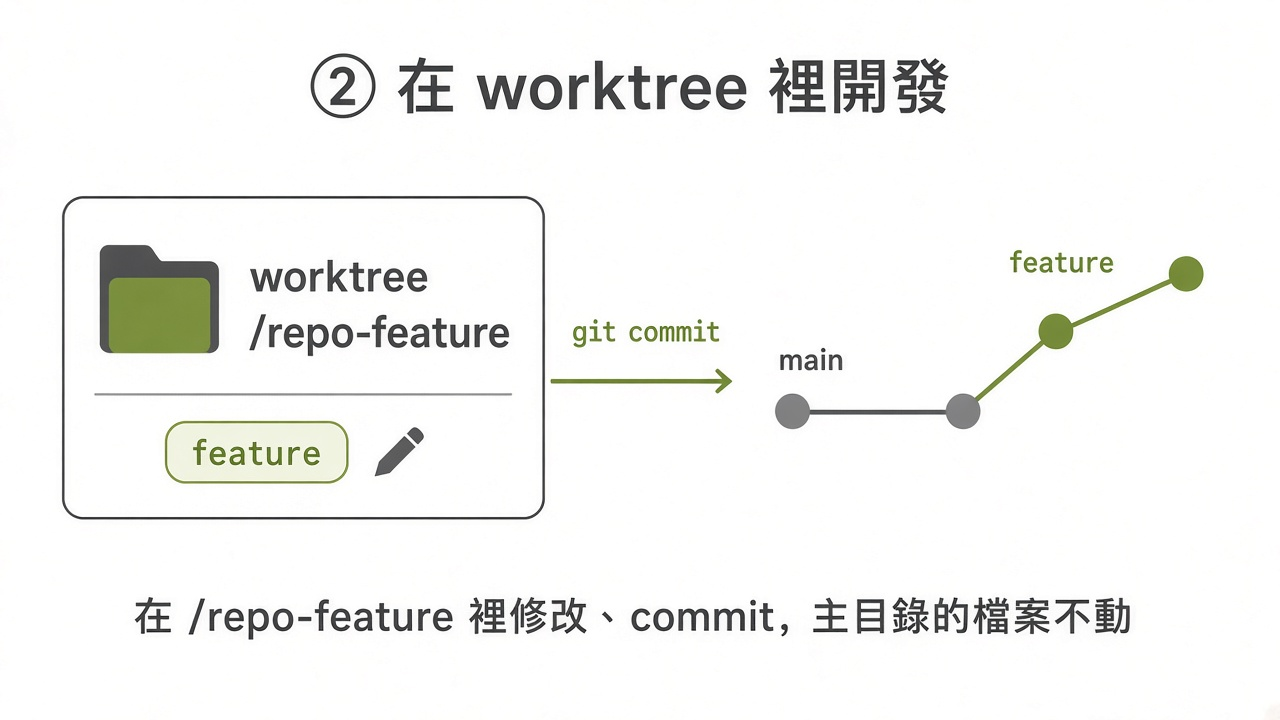
$ cd ../demo-feat
$ git add login.txt && git commit -m "add login"
[feat 863b3e3] add login
 1 file changed, 1 insertion(+)
這段期間 demo 不受影響,可以在那邊修別的東西,不用 stash。
3)回到主目錄 merge
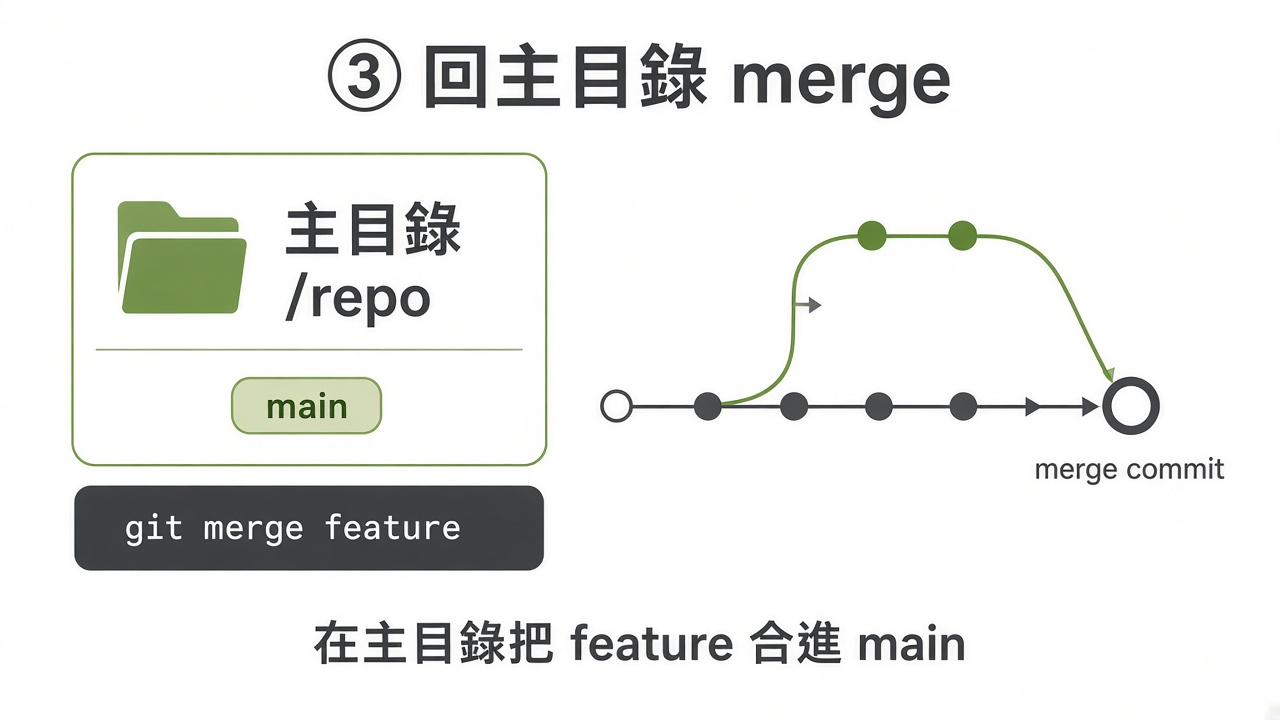
$ cd ../demo
$ git merge feat
Updating 6012220..863b3e3
Fast-forward
 login.txt | 1 +
 1 file changed, 1 insertion(+)
兩個 worktree 共用歷史,demo-feat 的 commit 在 demo 直接看得到,不用先 push 再 pull。要線性歷史就在 worktree 裡先 git rebase main 再 merge。
另一種做法是推到 GitHub,用 PR 合併。在 worktree 裡把分支推上去、開 PR(用 gh pr create 或在 GitHub 網頁上開),在 GitHub 上 merge 之後,回到主目錄把 main 更新下來:
$ cd ../demo-feat
$ git push -u origin feat
$ gh pr create

$ cd ../demo
$ git pull
在 GitHub 上 merge 不會動到本地,demo-feat 這個 worktree 和 feat 分支都還在,一樣要做第 4 步把它們刪掉。如果 PR 是用 squash 或 rebase 合併,GitHub 會產生新的 commit,本地的 git 看不出 feat 已經合進去,git branch -d feat 會以為分支還沒合併而拒絕刪除,確認 PR 已經 merge 之後,改用 git branch -D feat 強制刪除。
4)刪掉 worktree 與分支
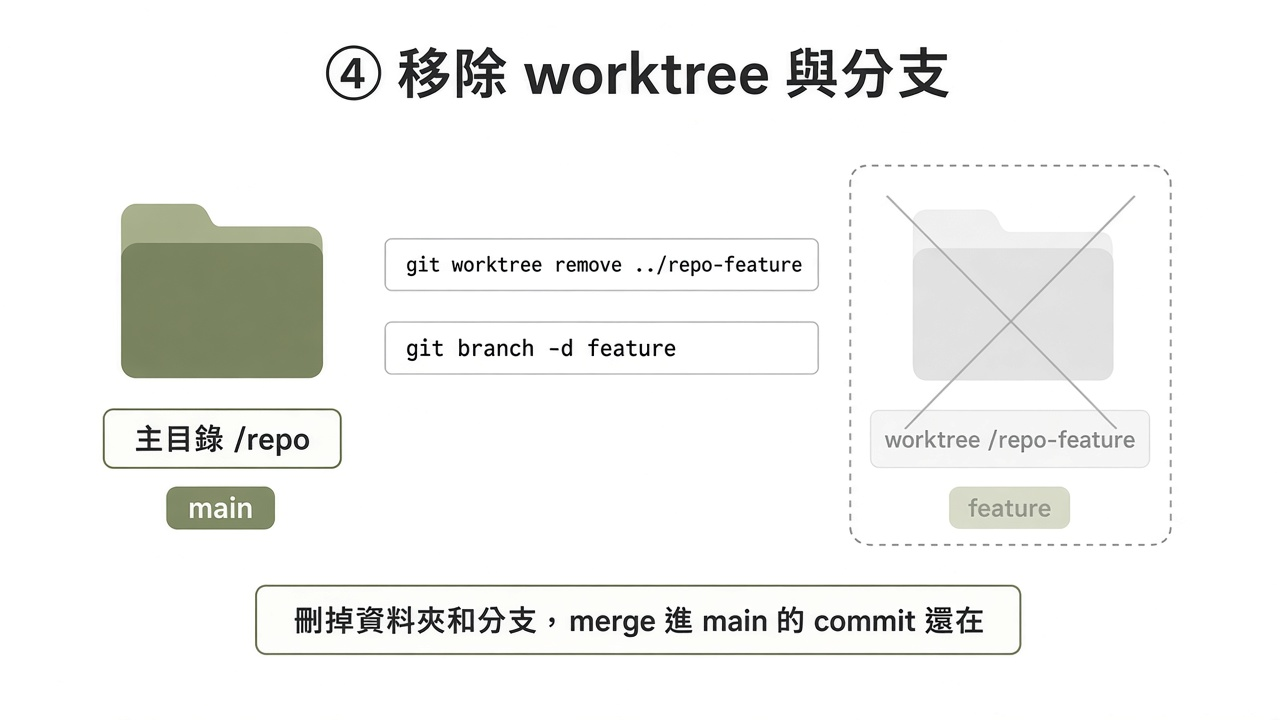
$ git worktree remove ../demo-feat
$ git branch -d feat
Deleted branch feat (was 863b3e3).

$ ls ..
demo
remove 只刪資料夾,分支要另外 git branch -d。資料夾裡有未提交的修改時,git 會拒絕刪除。
二、為什麼 agent 適合用 worktree
人同時開發兩個 feature 時,自己知道正在改哪些檔案,會先下 git stash 再切分支。agent 不知道其他 session 在做什麼,它會直接改檔、跑測試、切分支。我常在同一個 repo 同時開 2–3 個 agent session,例如一個改 CI 設定,一個加新功能,一個補測試,三個共用同一個資料夾時,一個 session 切了分支,另一個改到一半的檔案就跟著變了。
每個 session 開一個 worktree,各自在自己的分支上改,互相看不到對方改到一半的檔案。agent 改壞了就把整個 worktree 刪掉,主目錄不受影響。
三、以 Claude Code 為例:agent 怎麼管理 worktree
第一節的生命週期,換成 coding agent 來跑,就要有一套機制自動處理每一步,Claude Code 是一個做得完整的例子。建立的時候,它決定 worktree 放在哪裡、從哪個分支開出來,大型 repo 還能只 checkout 需要的資料夾(--worktree、worktree.baseRef、worktree.sparsePaths)。新的 worktree 是全新的 checkout,它會把沒進版控的 .env 複製進去,node_modules 這類資料夾直接連回主目錄,讓 worktree 開好就能跑(.worktreeinclude、worktree.symlinkDirectories)。
開發期間,它會擋下 agent 碰主目錄的操作,子代理也能各自拿到一個 worktree(isolation: worktree)。session 結束時,它會檢查 worktree 裡還有沒有修改,再決定刪掉還是留下。下面照這個順序看。
--worktree(簡寫 -w)
想讓 Claude 改程式,又不想讓它動到自己正在改的檔案,啟動時加 -w 與一個名字:
claude -w feature-authClaude Code 會在專案根目錄的 .claude/worktrees/feature-auth/ 建一個 worktree,開新分支 worktree-feature-auth,在裡面工作。另一個終端機換個名字再跑一次,就是第二個獨立的 session。把 .claude/worktrees/ 加進 .gitignore,主目錄才不會出現一堆未追蹤檔案。
要檢查某個 PR,可以用 claude -w "#1234"。# 要加引號,否則 shell 會當成註解。
worktree.baseRef
新 worktree 預設從遠端的預設分支(通常是 main)開出來,所以你在 feature 分支上還沒 push 的 commit,Claude 看不到。要從目前的位置開,在 .claude/settings.json 設定:
{ "worktree": { "baseRef": "head" } }"fresh"(預設):從 origin 的預設分支開。"head":從目前的HEAD開,包含本地還沒 push 的 commit。
只能填這兩個值,不能填分支名稱。要從特定分支開,自己用 git worktree add。
worktree.sparsePaths
大型 repo 可以只 checkout 列出的資料夾,加上根目錄的檔案,根目錄的資料夾不會帶上,所以範例裡列了 .claude:
{ "worktree": { "sparsePaths": [".claude", "packages/api", "packages/shared"] } }sparsePaths 不會自動帶上依賴的套件,monorepo 裡 packages/api 用到 packages/shared,就要兩個都列,少列一個,pnpm install 或 build 會因為找不到套件而失敗。比較適合各資料夾互相獨立、或只改文件的工作。
.worktreeinclude
新 worktree 是全新的 checkout,.env 這類被 .gitignore 排除的檔案不會跟過去。在專案根目錄建 .worktreeinclude,語法跟 .gitignore 相同:
.env
.env.local
config/secrets.json
只有符合規則、而且被 git 忽略的檔案會被複製,已追蹤的檔案不會重複複製。
worktree.symlinkDirectories
新的 worktree 是全新的 checkout,裡面沒有 node_modules,每開一個就要重新下一次 npm install,又慢又佔空間。把 node_modules 列進 symlinkDirectories,Claude Code 建 worktree 時會建一個 symlink 指回主目錄那份,worktree 開好就能直接跑:
{ "worktree": { "symlinkDirectories": ["node_modules"] } }路徑相對於 repo 根目錄。在 worktree 裡下 ls -la,node_modules 會顯示成 node_modules -> <主目錄>/node_modules,裡面的套件都是從主目錄讀的。
所有 worktree 共用同一份 node_modules,在 worktree 裡下 npm install,會直接寫進主目錄的 node_modules,其他 worktree 也跟著變。分支有改 package.json 的依賴時,那個 worktree 就不要用 symlink,自己另外裝一份。
Claude Code 在 worktree 裡會阻擋的操作
開發期間,Claude Code 會阻擋編輯主目錄的檔案、在主目錄執行指令,以及用 git -C 或 GIT_DIR 等方式把 git 操作導回主目錄。agent 執行期間,Claude Code 會對該 worktree 執行 git worktree lock,避免被其他清理流程刪掉。
子代理的 isolation: worktree
主 session 派出多個子代理同時改檔案時,它們會在同一個目錄互相覆蓋。在子代理定義檔(.claude/agents/refactorer.md)的 frontmatter 加上 isolation: worktree:
---
name: refactorer
description: Applies mechanical refactors across many files
isolation: worktree
---
這個子代理每次啟動都會拿到一個暫時的 worktree。
session 結束時 worktree 怎麼處理
Claude 的清理規則跟手動 git worktree remove 不同。互動式 session(claude -w)結束時,Claude 會檢查 worktree 裡有沒有刪掉就會遺失的東西:已修改或未追蹤的檔案、子模組裡未提交的修改、新的 commit。
- 沒有變更、session 沒命名:自動刪掉 worktree 與分支。
- 沒有變更、session 有命名:先問要不要保留。
- 有變更:問要保留還是刪除。保留會留下目錄與分支,之後用結束時印出的
claude --worktree <name> --resume回到同一個 worktree;刪除會連目錄、分支和裡面的修改一起清掉。 - 無法確認狀態(例如算不出變更數、檢查不了子模組):不自動刪,先問,並說明哪一項檢查失敗。
非互動模式(claude -p --worktree)結束時沒有詢問,不會自動清理。Claude Code 建 worktree 時加的 lock 會留著,直到之後某個 session 的過期 lock 清理把它釋放。手動刪除用 git worktree remove;git 回報 locked 就先 git worktree unlock。
子代理的 worktree 在子代理結束且沒有變更時自動刪掉;有變更就留在磁碟上,等定期清理(依 cleanupPeriodDays 設定)確認不會遺失修改再清。
四、我寫的 use-worktree skill
我同時用 Claude Code 和其他 agent。Claude Code 的原生 worktree 功能只管得到 Claude,換成其他 agent 就沒有同樣的行為;分支命名、worktree 放哪裡、誰負責刪除,我也想按自己的協作方式定。所以我自己寫了一份規則和腳本,各 agent 照同一套跑,代價是要自己維護。
一個工作單元一個 worktree
- 分支固定命名為
wu/<id>,<id>只能是小寫英數與連字號。 - worktree 的位置由專案設定決定,預設
.project/worktrees/,和工作單元的紀錄資料夾分開放:紀錄要長期保存、會被封存搬走,worktree 用完就刪。 - 腳本把放 worktree 的資料夾(預設
.project/worktrees/)寫進 repo 的info/exclude,不出現在版控裡,也不改任何已追蹤的檔案。 - 需要時才開;工作恢復時 worktree 還在就沿用,同一個單元不開第二個。
- 修正既有成果的單元直接在原分支上工作,不另開
wu/分支。
規則寫在 SKILL.md,動作交給腳本
SKILL.md 只寫規則:命名、何時開、誰刪、失敗怎麼辦。建立 worktree 交給一支零依賴的 Node.js 腳本 worktree.mjs:
node "<script>" ensure --branch wu/<id>               # 建立、沿用、重開或修復失效的登記
node "<script>" ensure --branch <existing> --id <id>  # 修正單元:使用既有分支
node "<script>" ensure --detach <sha>                 # 唯讀釘選某個 commit
node "<script>" setup --worktree <path>               # 執行專案宣告的初始化指令與檔案複製
輸出固定是一個 JSON 物件,agent 依 "error" 代碼判斷,不用解析給人看的訊息。
腳本沒有 remove 子指令,也不執行全域 git worktree prune。執行失敗就停下回報,不改用直接下 git worktree;路徑撞名時,不修改、不沿用、也不刪除那個路徑。setup 在每次建立或重開之後、寫任何程式之前執行,而且不在 worktree 之間 symlink 會變動的檔案。
誰刪 worktree
只有 orchestrator 會刪 worktree,在 worktree 裡工作的 worker 不刪。成功時,orchestrator 在審查通過、交付之後用 git worktree remove 刪;放棄時才允許強制刪除。worktree 不見了但 wu/<id> 分支還在,就在原分支重開。
在 graph 流程裡,orchestrator 建 worktree 並把路徑交給 worker。worker 只在這個路徑裡改檔案,不做任何版控操作;commit 由 orchestrator 在審查通過後於本地進行,收尾審查通過才 push。
目前用起來
目前多個 agent 照這套規則協作沒有出過問題。這只代表還沒碰到邊界情況,碰到了再改規則和腳本。
五、總結
worktree 的流程是用 git worktree add 開,在裡面 commit,回主目錄 merge 或走 PR 合併,最後 git worktree remove 加 git branch -d 收掉。agent 不知道其他 session 在做什麼,同時開多個 session 時,每個各用一個 worktree。Claude Code 已經把這套流程做進去,symlinkDirectories 設好 node_modules 就不用每次重裝套件,其他 agent 則靠我寫的 use-worktree skill 套用同樣的規則。
參考: